이 문서는 영어 원문을 자동 번역한 것으로, 내용이 원문과 다를 수 있습니다.영어 원문 보기
범용 정보 추출이란?
범용 정보 추출은 어떤 유형의 문서에서도 핵심 정보 추출을 가능하게 해주는 기능이에요. 특정 문서 유형에 맞춰 파인튜닝이 필요한 사전 빌드 정보 추출과 달리, 범용 정보 추출은 추가적인 학습이나 커스터마이징 없이도 임의의 문서에서 핵심 정보를 처리하고 추출할 수 있어요.
업스테이지 Information Extract를 사용해야 하는 이유
- 모든 문서 유형에 대응: 복잡한 PDF, 스캔 이미지, Microsoft Office 문서를 지원해 다양한 형식에서 매끄럽게 데이터를 추출할 수 있어요.
- 스키마 비종속 처리: 주어진 스키마에 따라 구조화된 출력을 동적으로 생성할 수 있어, 다양한 사용 사례에 맞춰 온디맨드 커스터마이징이 가능해요.
- 숨겨지거나 함축된 정보 추출: 명시적으로 표기된 정보뿐만 아니라, 여러 라인 아이템에서 총액을 산출하거나 문서에 직접 라벨링되지 않은 핵심 정보를 식별하는 등 함축적이거나 추론된 값까지 추출할 수 있어요.
- 파인튜닝 불필요: 사전에 정의된 템플릿이나 추가적인 모델 학습 없이도 관련 데이터를 추출해줘요.
업스테이지는 어떤 모델을 제공하나요?
| 별칭 | 현재 가리키는 모델 | RPS (자세히 보기) |
|---|---|---|
| information-extract | information-extract-260904 | 1 (Sync) / 2 (Async) |
| information-extract-nightly | - | 1 (Sync) / 2 (Async) |

세 단계로 간단하게 요청 보내기
업스테이지 Information Extract API는 OpenAI Chat Completion API의 요청 및 응답 형식을 따르도록 설계되었어요. OpenAI SDK를 사용해 요청을 구성하고 응답을 처리할 수 있어요.
messages에 입력 파일 추가
단일 파일을 입력할 수 있으며, 파일은 URL 또는 base64로 인코딩된 문자열로 messages 필드에 다음과 같은 형식으로 제공해주세요.
입력 파일에 대한 요구사항은 다음과 같아요.
- 지원 파일 형식: JPEG, PNG, BMP, PDF, TIFF, HEIC, DOCX, PPTX, XLSX, HWP, HWPX
- 최대 파일 크기: 50MB
- 파일당 최대 페이지 수: 100페이지
- 페이지당 최대 픽셀 수: 200,000,000 픽셀. (이미지가 아닌 파일의 경우, 파일을 150 DPI 이미지로 변환한 후 픽셀 수가 계산돼요.)
- 지원 문자 집합: 영숫자, 한글, 한자, 가타카나, 히라가나가 지원돼요. 중국어 한자(Hanzi)와 일본어 한자(Kanji)는 베타 버전으로, 사용은 가능하지만 완전하게 지원되지는 않습니다.
한자(Hanja), 중국어 한자(Hanzi), 일본어 한자(Kanji)는 한국, 중국, 일본의 문자 체계에서 사용되는 한자 기반 문자 체계예요. 유사한 면이 있지만, 각 언어적 맥락 안에서 시각적 표현, 발음, 의미, 사용 규약이 서로 달라요. 자세한 내용은 를 참고해주세요.
예시
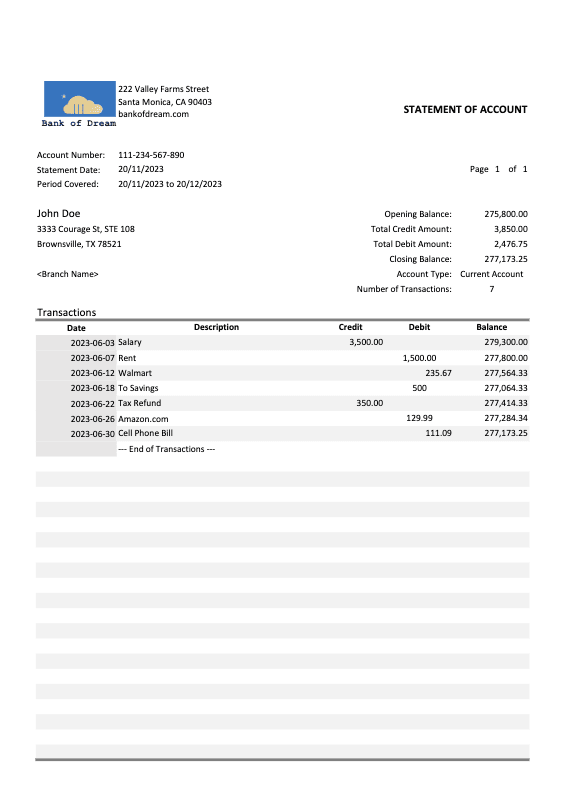
bank_statement.png
간단한 추출
정의된 JSON 스키마를 사용해 문서에서 구조화된 정보를 추출해요.
요청
응답
추출 모드 (Beta)
서로 다른 추출 모드를 사용해 문서에서 정보를 추출해요.
- Standard (
mode: "standard")는 대부분의 문서 유형에 대해 빠르고 정확한 추출을 제공하는 기본 추출 모드예요. - Enhanced (
mode: "enhanced")는 까다로운 문서에 대해 더 향상된 견고성을 제공하는 추출 모드예요.- 복잡한 표: 중첩된 표, 병합된 셀, 비정형 표 구조를 더 잘 처리해요.
- 품질이 낮은 스캔: 저해상도이거나 손상된 문서 스캔에서도 추출 성능이 향상돼요.
- 손글씨 텍스트: 손글씨 콘텐츠 인식이 강화돼요.
Enhanced 모드는 추가 비용이 발생해요. 자세한 내용은 요금 페이지를 참고해주세요.
요청
자주 묻는 질문
아래의 자주 묻는 질문을 확인해 보세요. 더 많은 FAQ는 FAQ 페이지를 참고해주세요.