광학 문자 인식(OCR)이란 무엇인가요?
업스테이지 Document OCR은 다양한 문서 이미지에서 텍스트를 효율적으로 감지하고 인식하도록 설계되어, 여러 언어와 이미지 품질에 걸쳐 높은 정확도와 다재다능함을 보장해요.
업스테이지에서는 어떤 모델을 제공하나요?
아래 표는 현재 API로 제공되는 모델 목록이에요. 업스테이지는 특정 모델 버전을 가리키는 안정적인 alias 를 제공하여, 한 번 연동하면 이후 업데이트의 혜택을 자동으로 받을 수 있도록 해요. 모델은 자주 업데이트될 수 있으므로 모델 이름을 하드코딩하기보다는 alias 사용을 권장해요.
| Alias | 현재 가리키는 모델 | RPS (자세히 알아보기) |
|---|---|---|
| ocr | ocr-260930 | 3 |
모델 출력 이해하기
실제 문서에서의 견고함
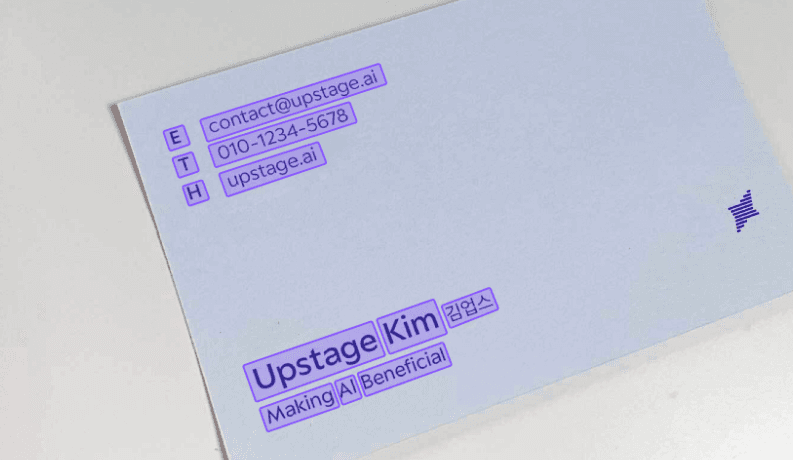
업스테이지 OCR 모델은 회전된 이미지, 워터마크, 노이즈, 체크박스 등을 포함한 다양한 문서 처리 시나리오에서 견고한 성능을 제공하도록 설계되었어요. 폭넓은 시나리오를 다루는 고품질 데이터셋으로 학습하여 텍스트를 정확하게 감지하고 인식해요. 회전된 문서에서도 단어 박스의 왼쪽 위 모서리를 정확히 감지하고, 학습 단계에서 워터마크와 체크박스를 무시하도록 함으로써, 문서에서 의미 있는 텍스트만 추출되도록 보장해요. 이를 통해 정확하고 효율적인 문서 처리 기능을 찾는 기업과 개인에게 이상적인 솔루션을 제공해요.
신뢰도 점수 활용
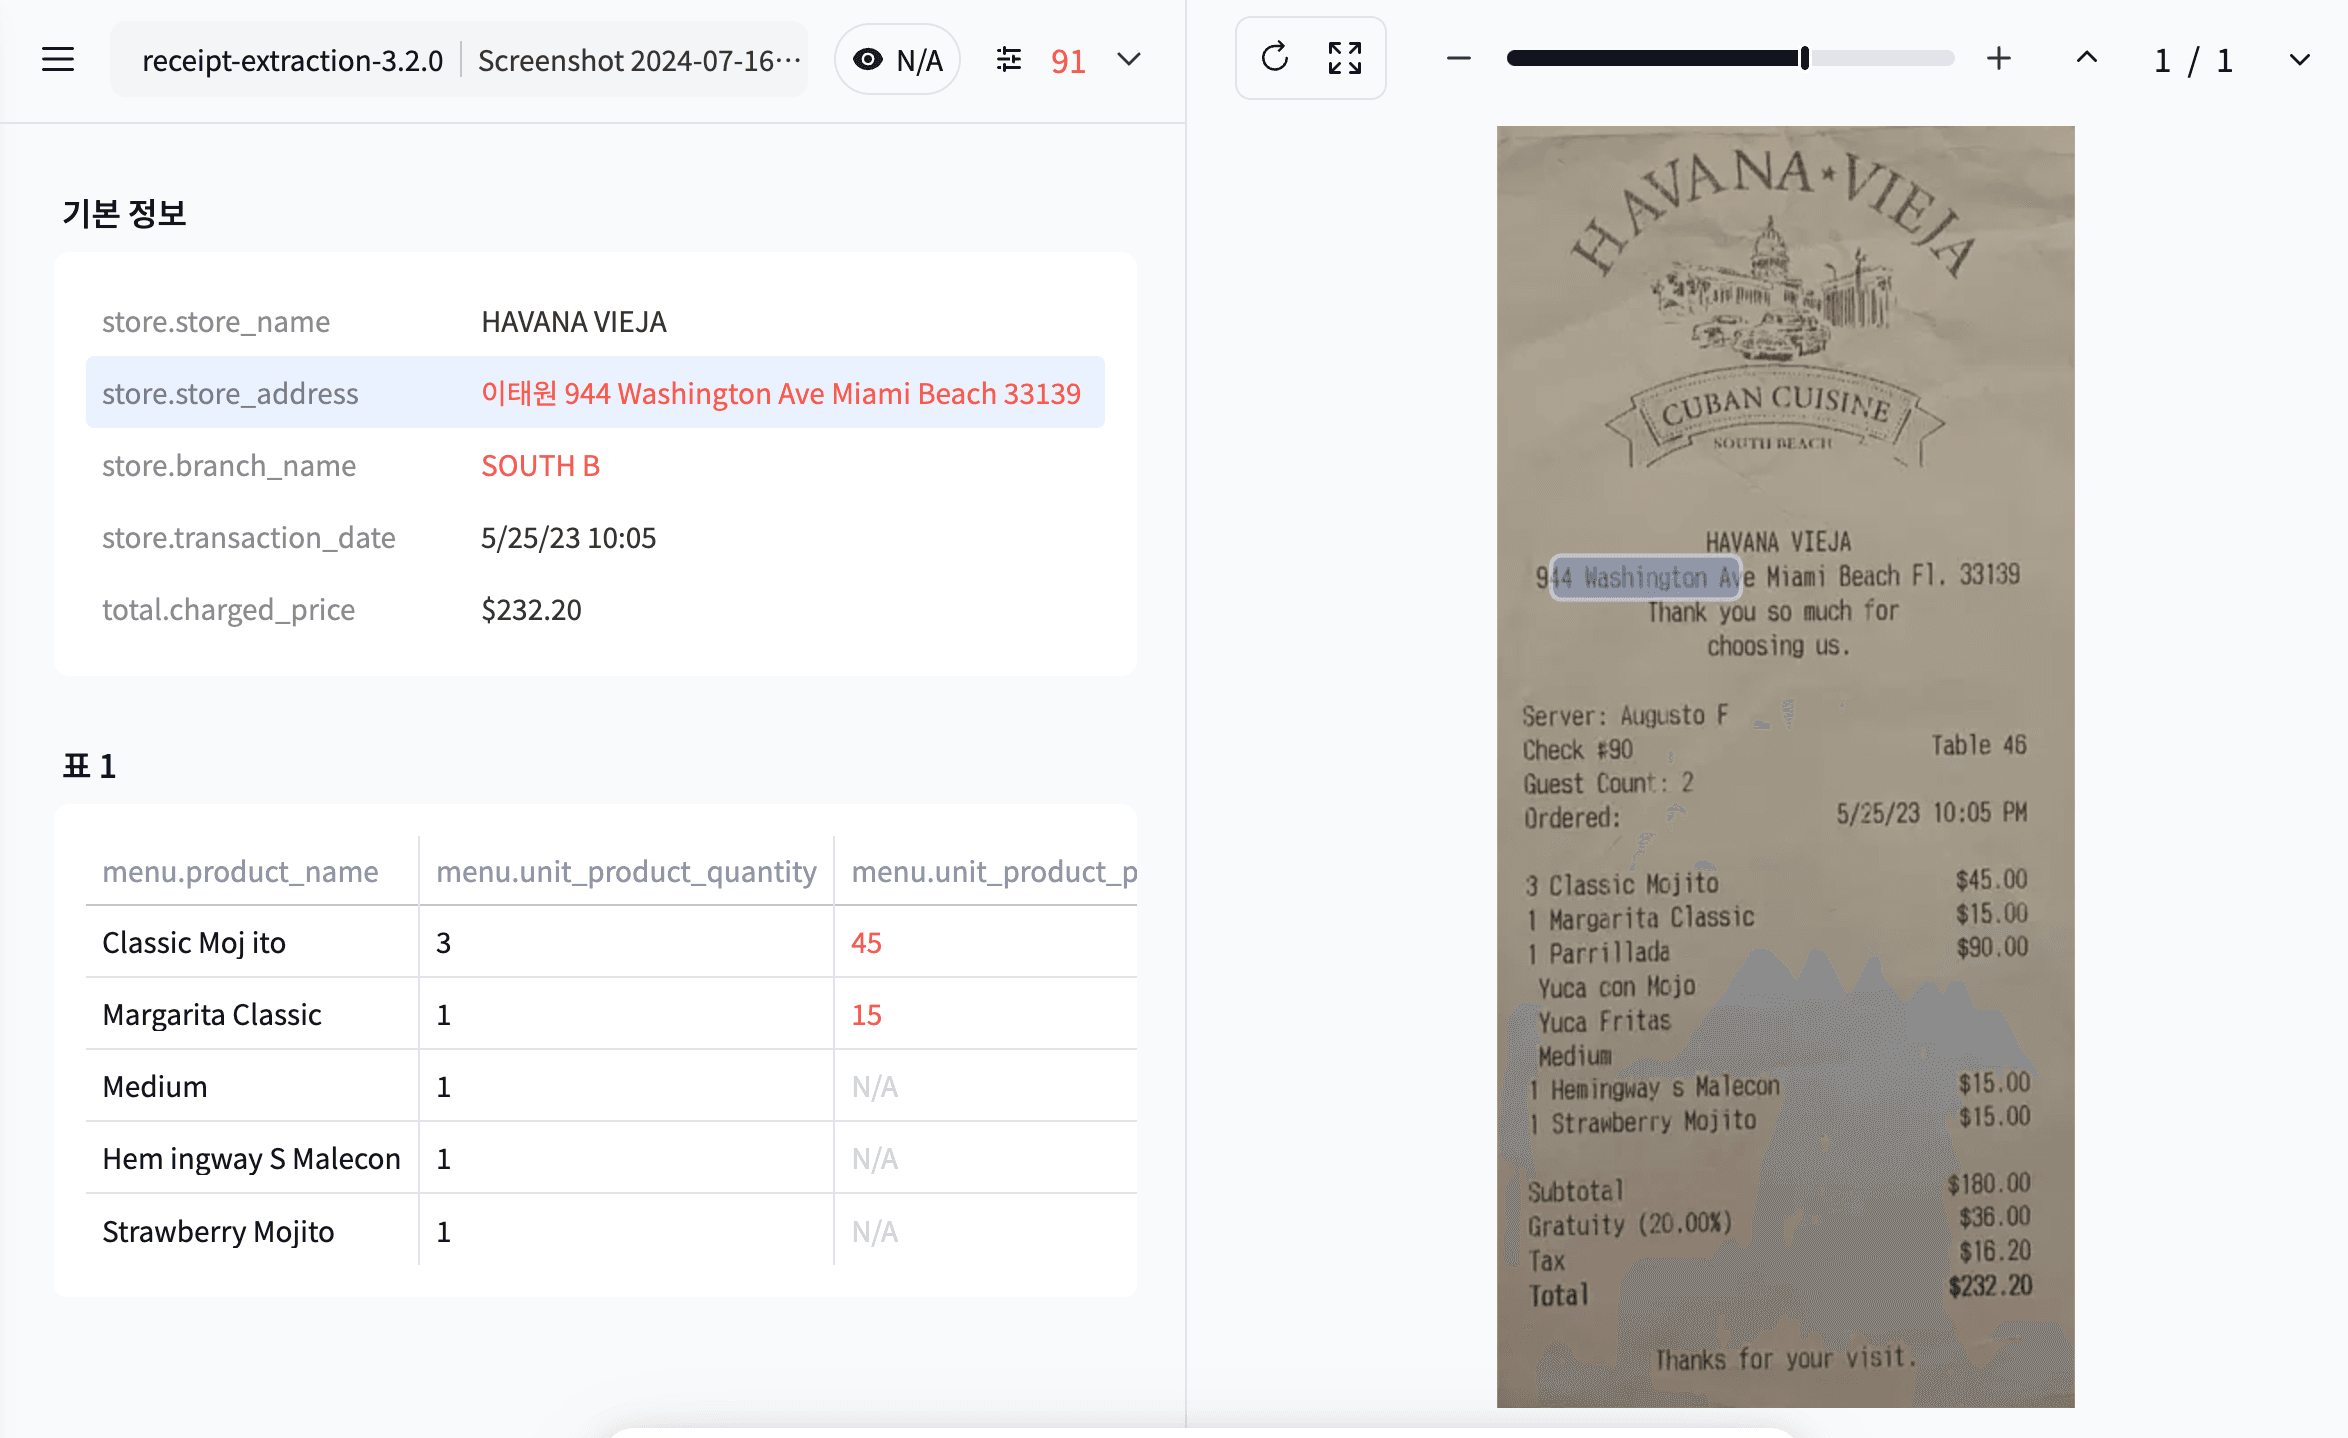
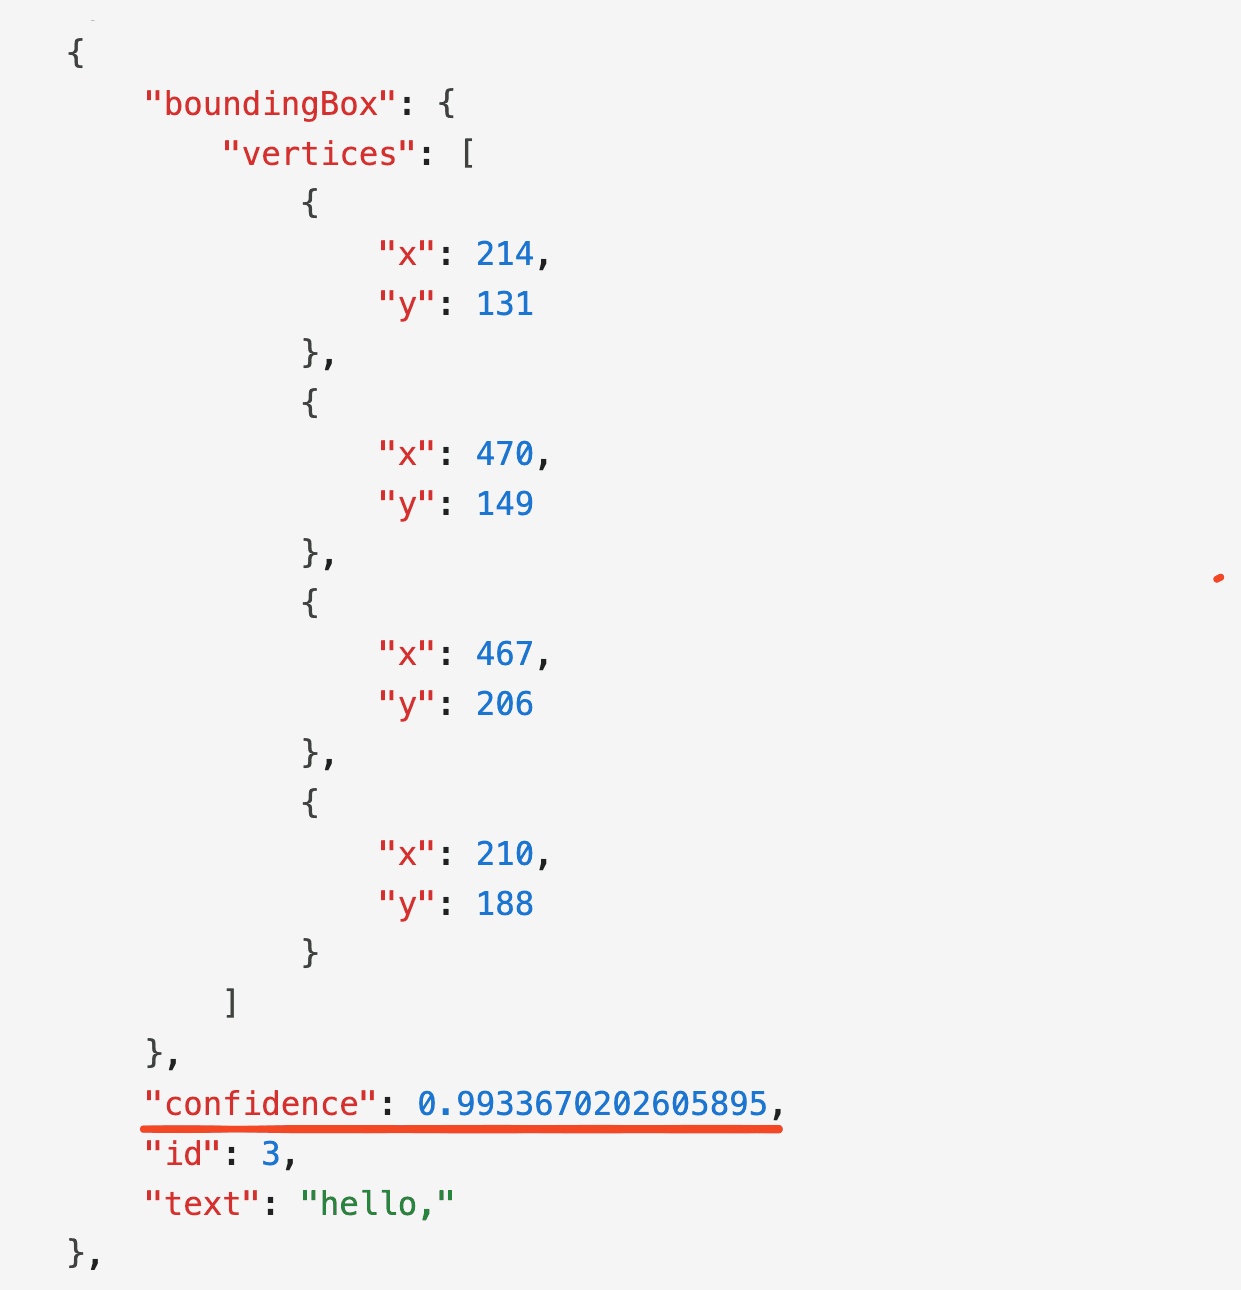
업스테이지 OCR은 문자 인식 과정에서 인식된 텍스트가 정확할 가능성을 측정하는 신뢰도 점수를 생성해요. 이 점수는 OCR 시스템 출력의 정확도를 나타내는 데 도움이 돼요. 점수는 처음에는 문자 단위로 생성되지만, 응용 프로그램에서 더 유용하게 사용할 수 있도록 단어 단위로 보정돼요. 신뢰도 점수는 인식된 콘텐츠를 시각화하거나 검증하는 데 사용할 수 있으며, 낮은 점수는 더 면밀히 검토하거나 필터링이 필요한 영역을 강조해요. 이러한 과정은 추출된 텍스트의 신뢰성을 평가하고 추가 검증이 필요한지 판단하는 데 도움을 주어 궁극적으로 전체 정확도와 사용자 신뢰를 향상시켜줘요.
요구 사항
- 지원 파일 형식: JPEG, PNG, BMP, TIFF, HEIC, WEBP, PDF, DOC, DOCX, PPT, PPTX, XLS, XLSX, CSV, TSV, HWP, HWPX
- 최대 파일 크기: 100MB
- 파일당 최대 페이지 수: 100페이지 (100페이지를 초과하는 파일은 413 오류로 거부돼요)
- 페이지당 최대 픽셀 수: 200,000,000픽셀. 이미지가 아닌 파일의 경우, 150 DPI 기준으로 이미지로 변환한 후 픽셀 수가 결정돼요.
- 지원 문자 집합: 알파벳/숫자, 한글, 한자가 지원돼요. 중국어 한자(Hanzi)와 일본어 한자(Kanji)는 베타 버전으로 제공되며, 사용은 가능하지만 완전히 지원되지는 않아요.
- 텍스트 크기: 페이지 크기의 약 30% 이하인 텍스트 크기에 최적화되어 있어요. 이 기준을 충족하지 않는 예시는 부적절한 예시로 간주되며 응답 오류로 이어질 수 있어요.
한자(Hanja), 중국어 한자(Hanzi), 일본어 한자(Kanji)는 한국어, 중국어, 일본어 표기 체계에서 사용되는 한자 기반의 문자 체계예요. 유사점에도 불구하고, 각각의 언어적 맥락 내에서 시각적 표현, 발음, 의미, 사용 관례가 서로 달라요. 자세한 내용은 이 문서를 참고해주세요.
예시
요청
응답
자주 묻는 질문
아래의 자주 묻는 질문을 확인해 보세요. 더 많은 FAQ는 FAQ 페이지에서 확인할 수 있어요.