Document Parsing이란 무엇인가요?
Document Parsing은 모든 문서를 HTML이나 Markdown과 같은 구조화된 텍스트로 자동 추출하는 과정이에요. 문단, 표, 이미지 등의 레이아웃 요소를 감지하여 문서의 구조를 파악해요. 이후 API는 읽기 순서에 따라 요소들을 직렬화하고, 최종적으로 문서를 구조화된 텍스트로 변환해요.
Playground에서 Document Parse를 체험해 보세요!
✓ 문서를 HTML 또는 Markdown으로 변환
✓ 샘플 또는 직접 준비한 파일 사용
✓ API 키 불필요 - 무료로 체험
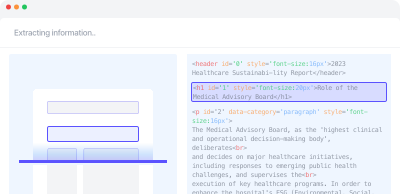
활용 사례 예시
- RAG 파이프라인: 비정형 문서의 구조 정보를 유지하면서 데이터베이스에 저장하는 RAG 파이프라인을 구축해요.
- Document QA: 문서 내 표, 차트, 기타 요소에서 정보를 추출하여 Document QA 기능을 강화해요.
- 문서 자동화: 챗봇, 요약, 정보 추출, 문서 처리 자동화 등 다양한 문서 기반 작업을 가능하게 해줘요.
시작하기
동기 또는 비동기 선택
동기 API는 대부분의 활용 사례에 적합하며 요청당 최대 100페이지까지 지원해요. 예시는 API 빠르게 시작하기를 참고해주세요. 100페이지를 초과하는 문서의 경우, 청크로 분할하여 동기 API를 사용하거나, 최대 2,000페이지까지 지원하는 비동기 API를 사용할 수 있어요. 두 가지 방식 모두 대용량 문서 처리에서 확인할 수 있어요.
모드 선택
Document Parsing은 세 가지 모드를 제공해요. 단순한 표가 포함된 텍스트 중심 문서에는 standard를 사용해주세요. 복잡한 표, 이미지, 차트 등 고급 시각 요소가 포함된 문서에는 enhanced를 사용해주세요. 페이지를 자동으로 standard 또는 enhanced로 분류하여 그에 맞춰 처리하려면 auto를 사용해주세요. enhanced 및 auto 모드는 document-parse-260128 이상 버전에서 사용할 수 있어요.
요청 보내기
요청 전송 방법은 API Reference를 참고해주세요. 입력 제약 조건은 입력 요구 사항 섹션을 참고해주세요.